كيف تبني قاعدة معرفة ذكية تجيب من ملفات شركتك؟ دليل RAG للمبتدئين
شرح عملي لكيفية تحويل ملفات الشركة وسياساتها وأدلة العمل إلى قاعدة معرفة يستطيع الذكاء الاصطناعي البحث فيها واسترجاع المعلومات المناسبة قبل الإجابة، بدل الاعتماد على معلومات عامة أو التخمين.
لدى كثير من الشركات عشرات أو مئات الملفات المهمة: سياسات داخلية، أدلة تشغيل، عقود، أسئلة شائعة، ملفات PDF، عروض، إجراءات دعم، مواصفات منتجات، مستندات تدريب، وتقارير. المشكلة ليست وجود المعلومات، بل الوصول إلى الجزء الصحيح منها في اللحظة التي يحتاجه الموظف أو العميل.
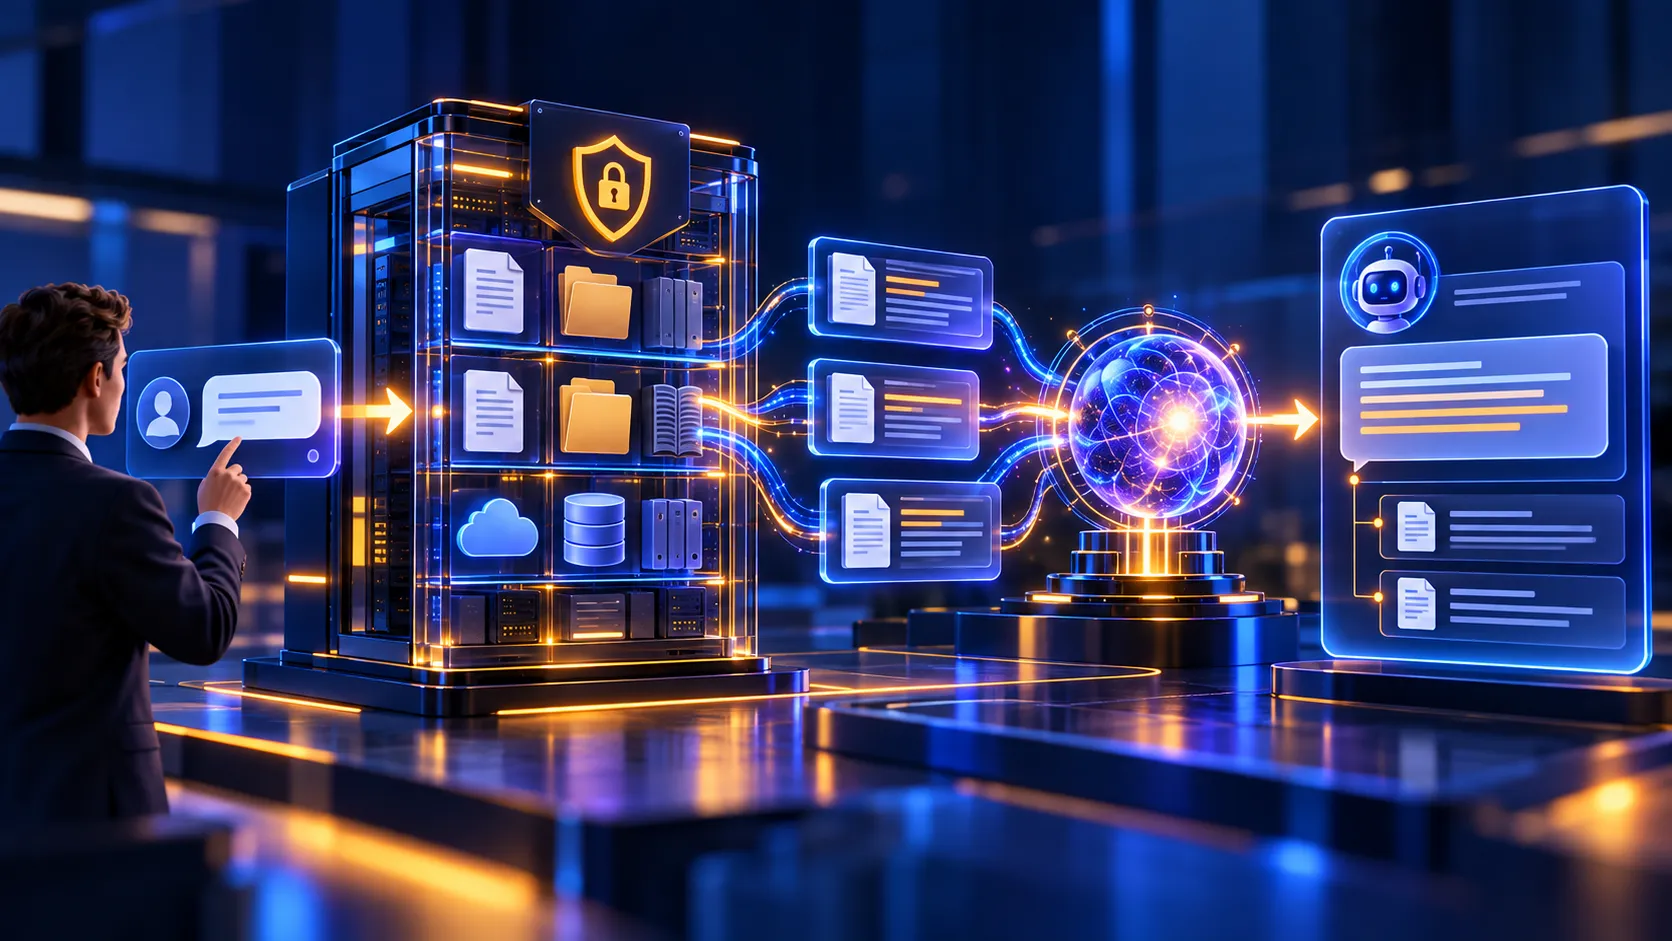
هنا تظهر فكرة قاعدة المعرفة الذكية. بدل أن يجيب نموذج الذكاء الاصطناعي اعتمادًا فقط على معرفته العامة، يتم أولًا البحث داخل ملفاتك، واختيار المقاطع الأكثر صلة بالسؤال، ثم تمرير هذه المقاطع إلى النموذج ليصوغ الإجابة. هذه الطريقة تُعرف عادة باسم Retrieval-Augmented Generation أو RAG.
RAG لا يجعل الذكاء الاصطناعي «يعرف كل ملفاتك» بالطريقة البشرية، ولا يضمن أن كل إجابة ستكون صحيحة. لكنه يغيّر نقطة البداية: من إجابة عامة إلى إجابة تستند إلى محتوى داخلي يمكن إدارته وتحديثه واختباره.
الخلاصة: RAG لا يعني تدريب نموذج جديد على ملفاتك. في السيناريو المعتاد تبقى الملفات في طبقة معرفة قابلة للبحث، ويسترجع النظام منها المقاطع المناسبة للسؤال ثم يضيفها إلى سياق النموذج وقت الإجابة.
ما هي قاعدة المعرفة الذكية؟
قاعدة المعرفة التقليدية قد تكون مجموعة مقالات داخل مركز مساعدة أو ملفات منظمة في مجلدات. المستخدم يبحث بالكلمات المفتاحية ويختار المستند الذي يبدو مناسبًا. قاعدة المعرفة الذكية تضيف طبقة بحث وفهم تساعد النظام على الوصول إلى المعنى، لا مجرد تطابق الكلمات.
مثلًا، إذا كانت إحدى سياسات الشركة تقول: «يمكن إرجاع المنتج غير المستخدم خلال 14 يومًا»، فقد يسأل الموظف: «هل أستطيع استرجاع طلب لم يُفتح بعد أسبوع؟». البحث الحرفي قد لا يجد تطابقًا قويًا بين «لم يُفتح» و«غير المستخدم»، بينما البحث الدلالي يحاول مطابقة المعنى.
توضح وثائق OpenAI أن البحث الدلالي يمكنه إظهار نتائج متقاربة في المعنى حتى عندما تشترك في كلمات قليلة أو لا تشترك في الكلمات نفسها، وتوفر Vector Stores لفهرسة الملفات والبحث فيها.
هذه الفكرة مفيدة جدًا عندما يكون الموظفون مضطرين للبحث في عشرات الأدلة والوثائق. ويمكن أن تصبح لاحقًا جزءًا من وكيل ذكاء اصطناعي ينفذ مهامًا، لكن الأفضل أولًا التأكد من أن طبقة المعرفة نفسها نظيفة وموثوقة.
ما هو RAG ببساطة؟
يمكن ترجمة المصطلح إلى «التوليد المعزز بالاسترجاع». ويتكون من جزأين: الاسترجاع، أي العثور على المعلومات المناسبة من ملفات أو قواعد بيانات؛ و التوليد، أي استخدام نموذج لغوي لصياغة الإجابة اعتمادًا على ما تم استرجاعه.
تصف Microsoft RAG بأنه نمط يوسع قدرات النماذج اللغوية عبر تأسيس الإجابات على محتوى خاص بالمؤسسة. وتوضح أن التحدي العملي لا يقتصر على «ربط ملفات بالنموذج»، بل يشمل فهم الاستعلام، الوصول إلى عدة مصادر، حدود السياق، زمن الاستجابة، والأمان والصلاحيات.
المكونات الأساسية لقاعدة معرفة تعمل بـRAG
يمكن تنفيذ RAG بطرق مختلفة، من أدوات جاهزة بلا كود إلى بنية مخصصة بالكامل. لكن معظم الأنظمة تحتوي على المكونات نفسها تقريبًا.
| المكوّن | وظيفته | مثال |
|---|---|---|
| مصادر البيانات | المحتوى الذي تريد أن يعتمد عليه النظام | PDF، DOCX، صفحات مساعدة، سياسات، أدلة تشغيل |
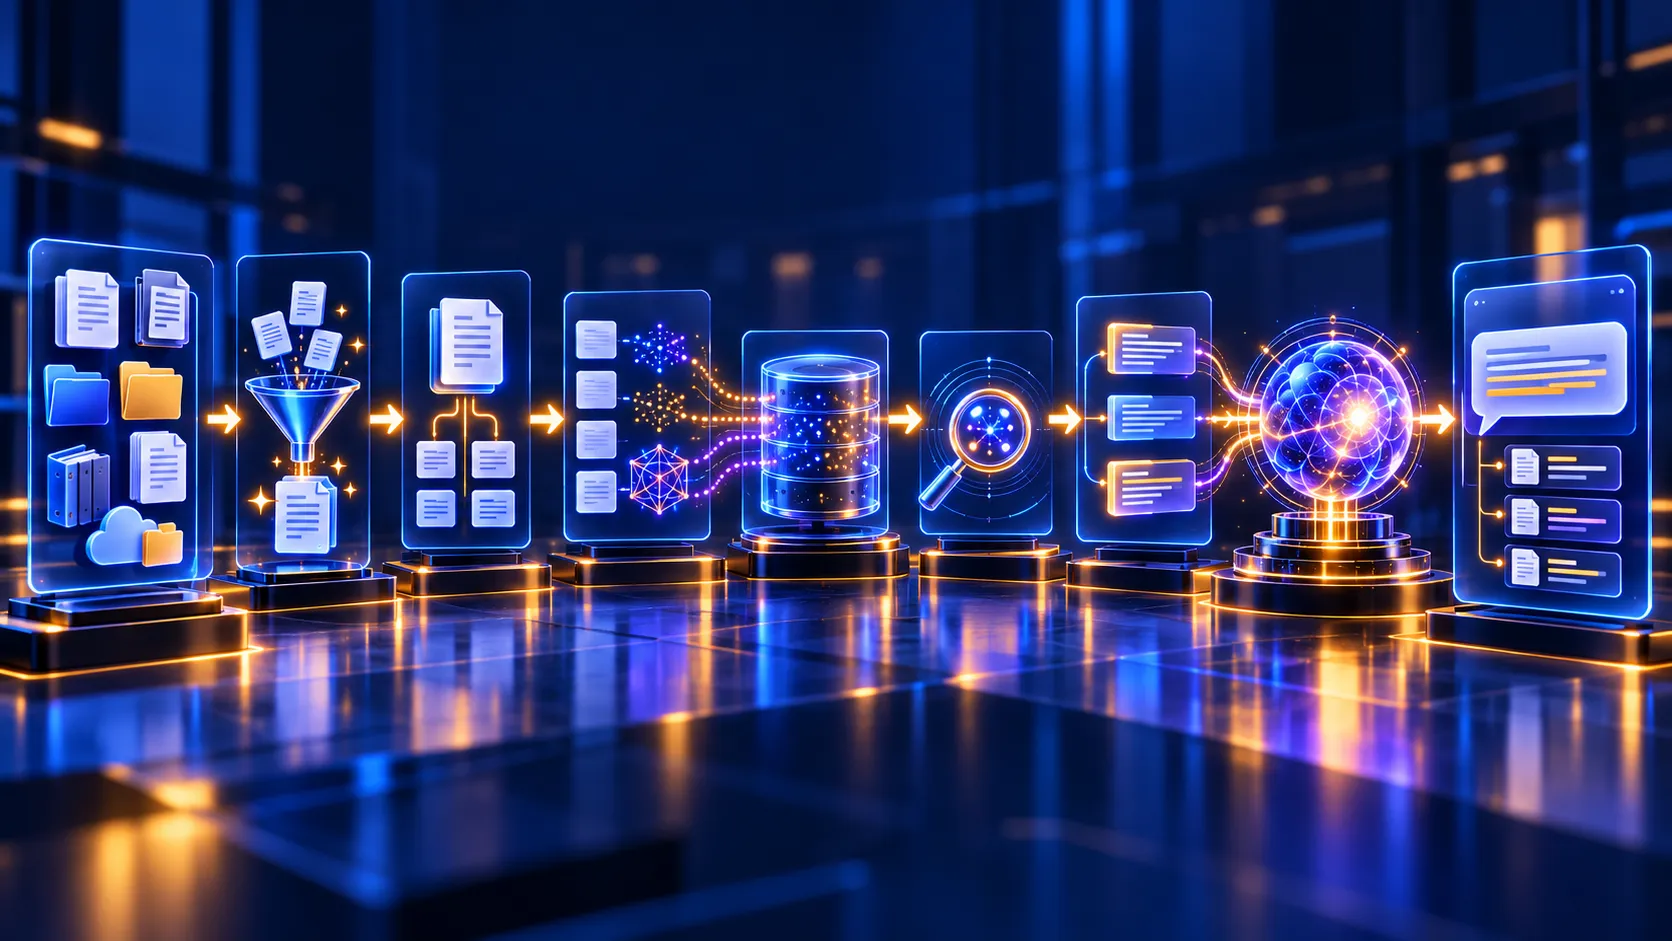
| معالجة المحتوى | استخراج النص وتنظيفه وتقسيمه إلى وحدات مناسبة | تحويل تقرير طويل إلى مقاطع قابلة للبحث |
| الفهرس أو Vector Store | تخزين تمثيلات قابلة للبحث واسترجاع المقاطع | قاعدة ملفات مفهرسة دلاليًا |
| الاسترجاع | اختيار أكثر المقاطع ارتباطًا بالسؤال | البحث عن سياسة الاسترجاع المناسبة |
| النموذج اللغوي | صياغة إجابة مفهومة باستخدام السياق المسترجع | تلخيص السياسة في رد قصير للموظف |
| الضوابط | تحديد ما يراه المستخدم وما يجب أن يرفضه النظام | منع موظف من رؤية ملفات قسم لا يملك صلاحية عليها |
في خدمات مثل File Search من OpenAI، يمكن إنشاء Vector Store ورفع الملفات، ثم يستخدم النظام البحث الدلالي وبحث الكلمات المفتاحية لاسترجاع المقاطع المناسبة قبل توليد الرد. وتوضح الوثائق أن الملفات المضافة إلى Vector Store تُقسّم وتُحوّل إلى تمثيلات دلالية وتُفهرس تلقائيًا.
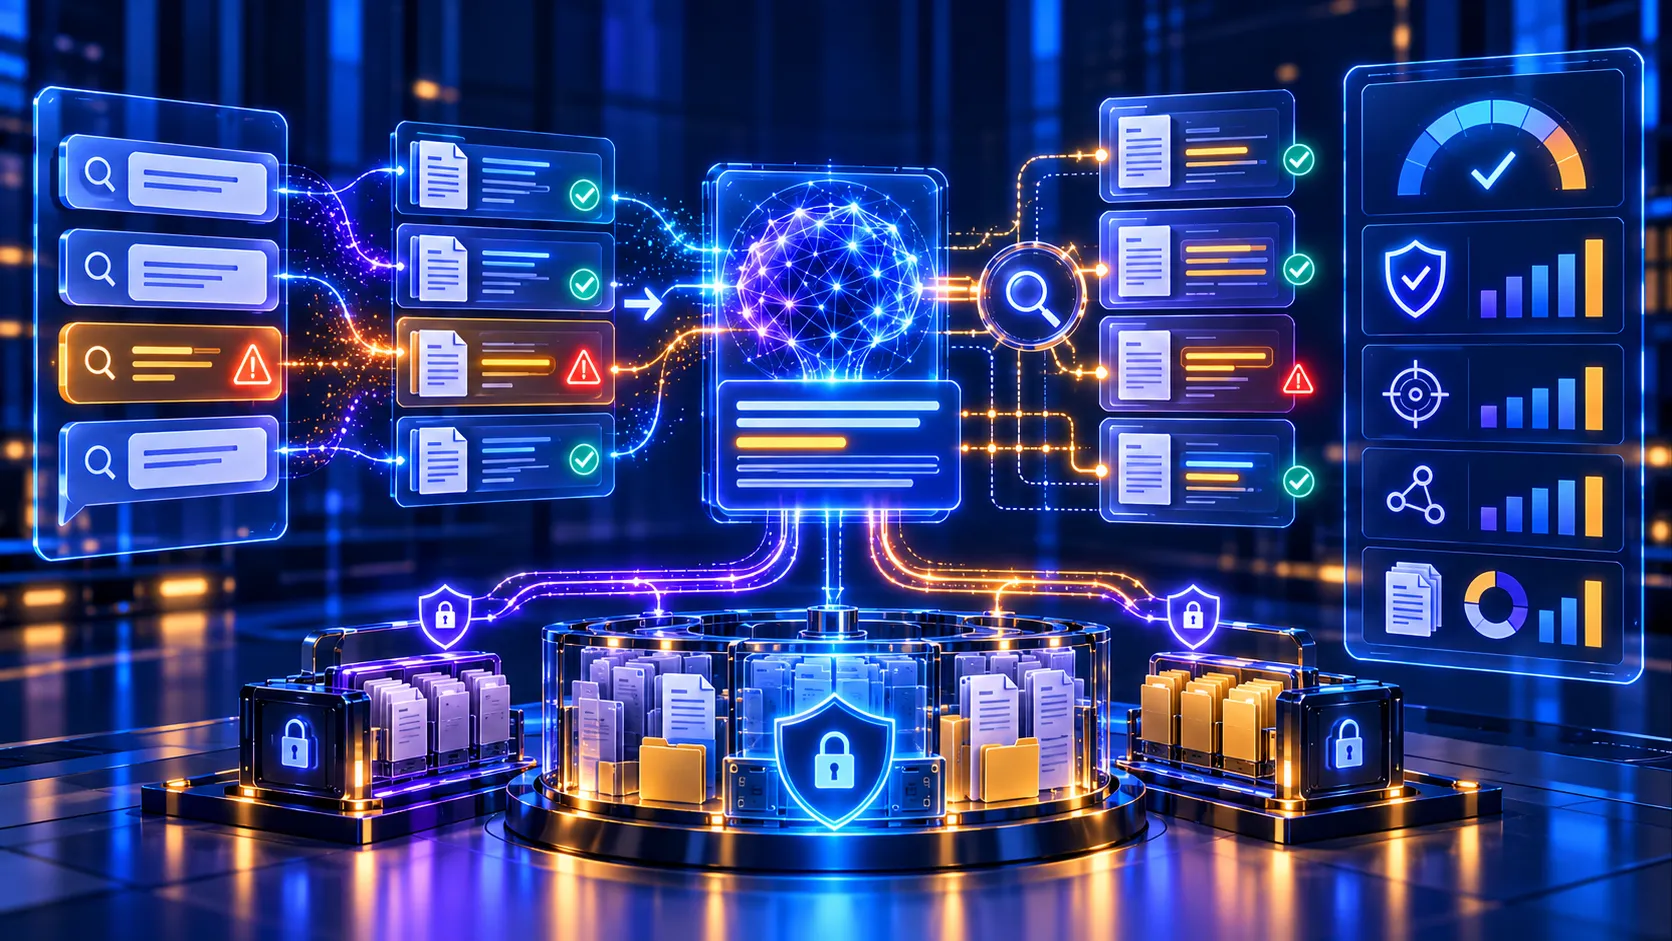
كيف تعمل عملية RAG خطوة بخطوة؟
ما الملفات المناسبة لبناء قاعدة المعرفة؟
أفضل الملفات ليست بالضرورة الأكثر عددًا، بل الأكثر موثوقية وفائدة. إذا رفعت كل ما لديك بلا فرز، قد تنتهي بقاعدة تحتوي سياسات قديمة ونسخًا متعارضة ومسودات لم تعتمد قط.
- سياسات الشركة المعتمدة: الإرجاع، الضمان، الشحن، خدمة العملاء، الموارد البشرية.
- أدلة التشغيل: خطوات تنفيذ مهمة أو حل مشكلة.
- الأسئلة الشائعة: خصوصًا الأسئلة التي تتكرر على العملاء أو الموظفين.
- وثائق المنتجات: المواصفات، طريقة الاستخدام، المشاكل المعروفة.
- أدلة التدريب: المواد التي يحتاج الموظف للرجوع إليها أثناء العمل.
- المستندات المرجعية: العقود أو القوالب عندما تكون الصلاحيات والاستخدام واضحين.
إذا كانت الوثائق بلغات مختلفة، يمكن أن تحتاج إلى تنظيم أو ترجمة مع المحافظة على النسخة الأصلية المرجعية. لدينا دليل مستقل عن ترجمة الوثائق التقنية والكتب بالذكاء الاصطناعي يشرح الاعتبارات العملية للترجمة والمراجعة.
لا تجعل مجلد «كل شيء» قاعدة معرفة. وجود معلومات غير معتمدة أو قديمة داخل الفهرس قد يكون أخطر من نقص المعلومات، لأن النظام قد يسترجعها ويصيغها بثقة.
ما معنى تقسيم المستندات إلى Chunks؟
النموذج لا يحتاج عادةً إلى قراءة وثيقة من 200 صفحة كاملة للإجابة عن سؤال واحد. لذلك تُقسّم الوثائق إلى أجزاء أصغر تسمى Chunks. عندما يسأل المستخدم، يبحث النظام عن أفضل هذه الأجزاء بدل إرسال المستند كله.
حجم المقطع مهم. إذا كان صغيرًا جدًا، قد يفقد السياق: فقرة تقول «يُستثنى من ذلك…» من دون الفقرة السابقة لن تكون مفهومة. وإذا كان كبيرًا جدًا، قد يجلب كثيرًا من المحتوى غير الضروري ويستهلك مساحة السياق ويضعف التركيز.
لا توجد قيمة سحرية تناسب كل الملفات. العقود والسياسات والجداول والأدلة التقنية لها بنى مختلفة. الأفضل أن تختبر تقسيمًا يحافظ على وحدة المعنى: قسم، إجراء، فقرتان مترابطتان، أو مجموعة خطوات كاملة.
نصيحة عملية: استخدم العناوين والبنية الطبيعية للمستند قدر الإمكان. تقسيم فصل أو سياسة حسب H2 وH3 غالبًا أفضل من القطع العشوائي كل عدد ثابت من الأحرف.
البحث الدلالي أم بحث الكلمات المفتاحية؟
البحث بالكلمات المفتاحية ممتاز عندما يعرف المستخدم المصطلح نفسه الموجود في الوثيقة. أما البحث الدلالي فيحاول التقاط المعنى حتى إذا كانت صياغة السؤال مختلفة. كثير من أنظمة RAG الحديثة تجمع بين الاثنين بدل اختيار واحد فقط.
OpenAI File Search، مثلًا، يدعم البحث الدلالي والكلمات المفتاحية على الملفات المرفوعة. كما تسمح واجهات الاسترجاع باستخدام خصائص ومرشحات Metadata لتضييق النتائج حسب خصائص الملفات.
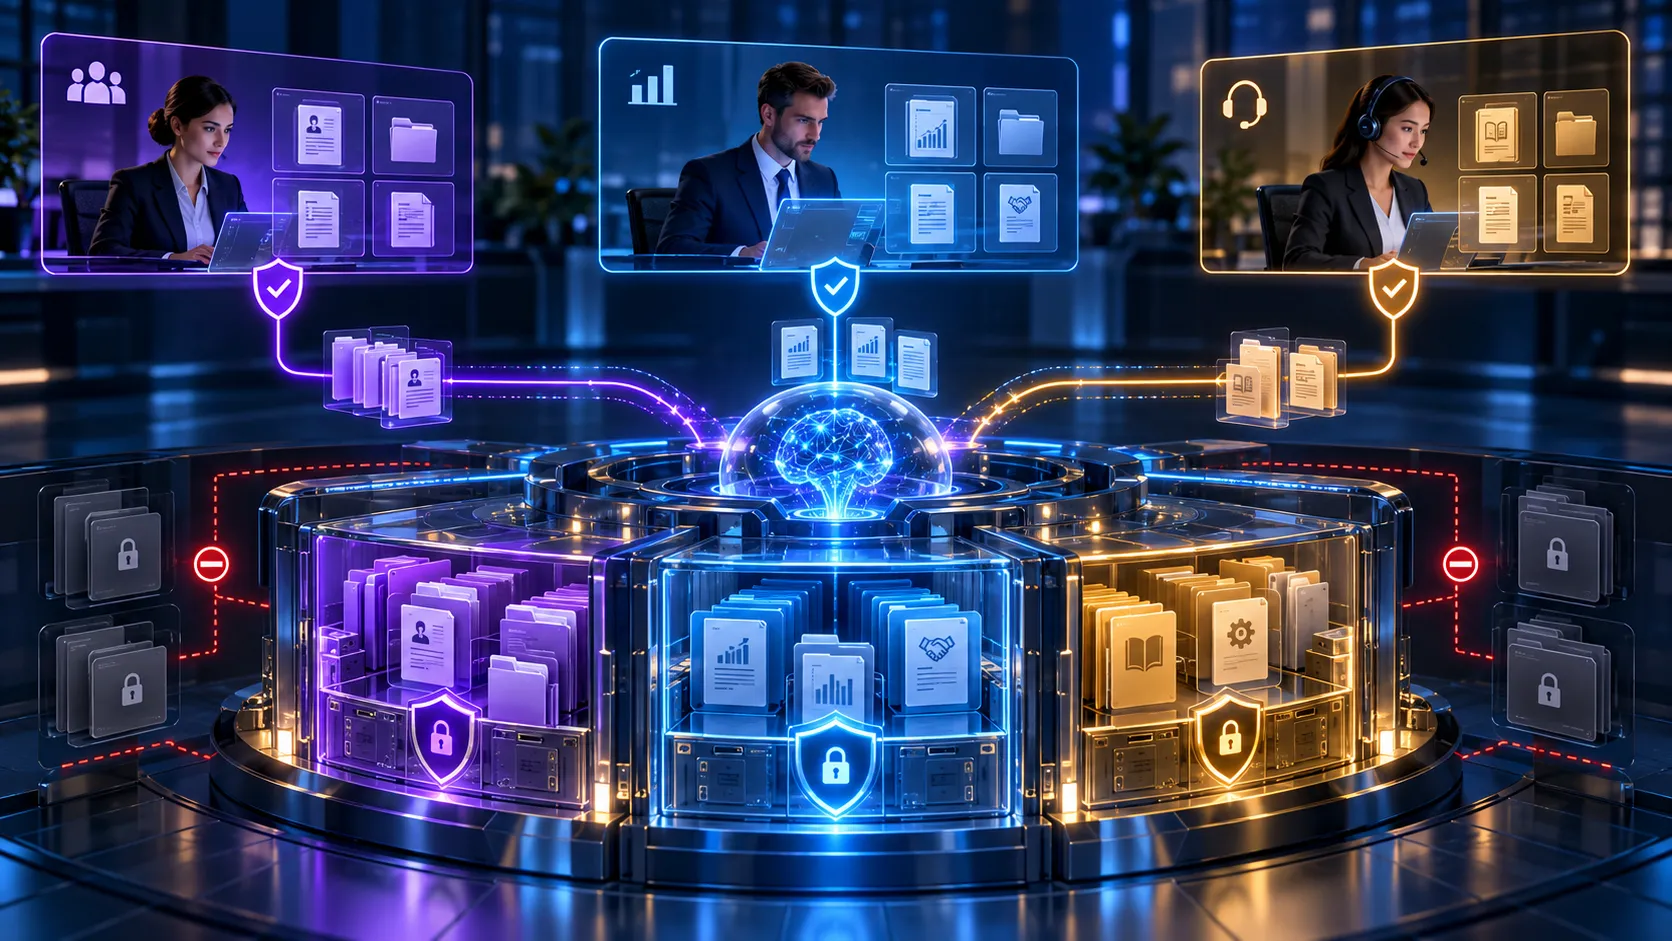
الـMetadata مفيدة جدًا في الشركات. يمكنك وسم الملف بأنه يخص «الموارد البشرية» أو «السعودية» أو «المنتج A»، ثم منع النظام من خلط سياسات أسواق أو أقسام مختلفة.
كيف تجعل الإجابة قابلة للتحقق؟
قاعدة المعرفة الجيدة لا تكتفي بإعطاء جواب جميل؛ بل تساعد المستخدم على معرفة من أين جاءت المعلومة. لذلك احتفظ دائمًا باسم المصدر وربما عنوان القسم أو الصفحة أو رابط الوثيقة عندما تسمح البنية بذلك.
يمكن أن تطلب من النظام أن يذكر المصدر في نهاية كل إجابة، أو أن يعرض «المستند المستخدم» للموظف. وإذا لم يجد مصدرًا كافيًا، يجب أن يقول ذلك بوضوح بدل توليد جواب يبدو منطقيًا.
هذه النقطة ترتبط مباشرة بمقالنا كيف تتحقق من إجابات الذكاء الاصطناعي وتقلل الهلوسة؟ . RAG يقلل مساحة التخمين عندما يعمل جيدًا، لكنه لا يلغي الأخطاء؛ فقد يسترجع النظام المقطع الخطأ أو يفسر المعلومة بصورة غير دقيقة.
قاعدة مناسبة: «لا يوجد مصدر = لا يوجد جواب قطعي». إذا لم تعثر طبقة الاسترجاع على دليل واضح، اجعل النظام يطلب توضيحًا أو يحيل السؤال إلى شخص مختص.
الصلاحيات والخصوصية: لا تجعل البحث الذكي يكشف ملفات الشركة
إذا كانت قاعدة المعرفة تضم ملفات داخلية، يجب ألا يحصل كل مستخدم على كل شيء. RAG لا يحل مشكلة الصلاحيات تلقائيًا. إذا سمحت لمحرك البحث باسترجاع مستند لا يحق للمستخدم رؤيته، قد يظهر جزء منه داخل الإجابة.
تضع Microsoft الأمن والحوكمة ضمن التحديات الأساسية لـRAG في المؤسسات، وتؤكد أن المستخدمين والوكلاء يجب ألا يسترجعوا إلا المحتوى المصرح لهم به.
وقبل رفع ملفات العملاء أو بيانات الموظفين إلى أي خدمة AI، راجع دليل حماية البيانات والخصوصية عند استخدام أدوات الذكاء الاصطناعي . التقنية لا تلغي مسؤولية تحديد ما يجوز مشاركته وأين تتم معالجة البيانات.
كيف تختبر جودة قاعدة المعرفة قبل إطلاقها؟
اختبار RAG يجب أن يقيس الاسترجاع والإجابة معًا. أحيانًا يكون النموذج ممتازًا لكنه تلقى مقطعًا غير مناسب، وأحيانًا يكون الاسترجاع صحيحًا لكن الصياغة النهائية أضافت استنتاجًا غير موجود.
أنشئ مجموعة أسئلة اختبار من الاستخدام الحقيقي، وليس أسئلة سهلة فقط. أضف أسئلة بصياغات مختلفة، أسئلة غامضة، وأخرى لا توجد لها إجابة داخل الملفات. ثم سجّل النتيجة المطلوبة والمصدر الصحيح وقارنها بما يسترجعه النظام.
وإذا كنت تستخدم الذكاء الاصطناعي في البحث أو العمل مع مصادر كثيرة، فدليل الذكاء الاصطناعي للبحوث وكتابة المحتوى يساعدك على التمييز بين العثور على مصدر وبين تقييم جودته.
خطة تنفيذ بسيطة لشركة صغيرة
لا تحتاج إلى عشرات الآلاف من الملفات لتبدأ. في الواقع، قاعدة صغيرة نظيفة أفضل لاختبار الفكرة. اختر حالة واحدة لها قيمة واضحة، مثل مساعدة فريق الدعم على الإجابة عن سياسات الشحن والاسترجاع.
- حدد حالة استخدام واحدة: لا تبدأ بكل الشركة.
- اختر 20–50 مستندًا معتمدًا: واحذف النسخ القديمة والمكررة.
- نظم العناوين والنسخ: اجعل لكل مستند اسمًا واضحًا وتاريخ تحديث ومالكًا.
- أنشئ فهرسًا أو Vector Store: باستخدام خدمة جاهزة أو بنية مخصصة.
- اختبر الاسترجاع قبل التوليد: تأكد أن السؤال يعيد المقطع الصحيح.
- أضف النموذج والتعليمات: «أجب من المصادر فقط، وإذا لم تجد فلا تخمّن».
- أظهر المصدر: اجعل الموظف يستطيع فتح الوثيقة المستخدمة.
- اختبر 50 سؤالًا حقيقيًا: وصنف الأخطاء إلى استرجاع أو صياغة أو بيانات.
- ابدأ داخليًا: دع الموظف يراجع الإجابات قبل تعريض النظام للعملاء.
- وسع تدريجيًا: أضف أقسامًا جديدة بعد ثبات الجودة.
إذا نجحت هذه المرحلة، يمكن لاحقًا ربط قاعدة المعرفة بوكيل يقوم بمزيد من الخطوات. عندها يصبح مقال بناء وكيل ذكاء اصطناعي هو المرحلة التالية الطبيعية.
أخطاء شائعة تجعل RAG يعطي نتائج ضعيفة
رفع ملفات كثيرة قبل تنظيفها
المشكلة ليست «قلة البيانات» دائمًا. أحيانًا لديك بيانات كثيرة لكنها متضاربة. إذا كانت ثلاث وثائق تعطي ثلاث سياسات مختلفة، قد يسترجع النظام أيًا منها.
الاعتماد على Embeddings وحدها
البحث الدلالي قوي، لكنه ليس كاملًا. أرقام العقود، أسماء المنتجات، الأكواد، الاختصارات والمصطلحات الدقيقة قد تستفيد من بحث كلمات مفتاحية أو Metadata أو أسلوب هجين.
عدم تحديث الفهرس عند تغير الوثائق
إذا تغيرت سياسة الشركة ولم تتغير قاعدة المعرفة، سيستمر النظام في تقديم المعلومة القديمة. يجب أن يكون تحديث المحتوى جزءًا من سير العمل، لا مهمة طارئة.
إرسال نتائج كثيرة جدًا للنموذج
استرجاع عشرات المقاطع لا يعني جوابًا أفضل. السياق الزائد يمكن أن يجعل النموذج أقل تركيزًا ويزيد التكلفة والوقت. تسمح أدوات الاسترجاع الحديثة بتحديد عدد النتائج المسترجعة لتحقيق توازن بين السرعة والجودة.
عدم وجود سياسة «لا أعرف»
إذا كان النظام مجبرًا على الإجابة عن كل سؤال، سيحاول ملء الفراغ. تعليمات الرفض والتصعيد ليست عيبًا في المنتج؛ بل حماية للجودة.
هل أستخدم أداة جاهزة أم أبني RAG بنفسي؟
الأداة الجاهزة تناسب الفريق الذي يريد اختبار حالة واضحة بسرعة ولا يحتاج تحكمًا عميقًا. أما النظام المخصص فيعطيك تحكمًا أكبر في مصادر البيانات، التقسيم، ترتيب النتائج، المرشحات، الصلاحيات، القياس والتكامل مع أنظمتك.
| النهج | مناسب عندما | الميزة | التحدي |
|---|---|---|---|
| أداة جاهزة | تريد تجربة سريعة بملفات محدودة | إعداد أسرع ومكونات أقل | مرونة أقل في التخصيص |
| File Search مُدار | تبني تطبيقًا وتريد استرجاع الملفات دون إدارة كل طبقة بنفسك | فهرسة واسترجاع مستضافان | تظل بحاجة لتصميم الصلاحيات والاختبار |
| بنية RAG مخصصة | لديك مصادر متعددة ومتطلبات مؤسسية | تحكم أوسع في البحث والترتيب والحوكمة | تكلفة هندسية وتشغيلية أعلى |
لا تختَر التقنية قبل تحديد حالة الاستخدام. السؤال الأفضل ليس «ما أفضل Vector Database؟» بل «ما السؤال الذي نريد أن يجيب عنه النظام، وما المصدر الموثوق الذي يجب أن يستخدمه، ومن يحق له رؤية النتيجة؟».
قائمة فحص قبل إطلاق قاعدة معرفة ذكية
- هل حددت حالة استخدام واضحة بدل محاولة تغطية كل ملفات الشركة؟
- هل الملفات معتمدة ومحدثة ولا توجد نسخ متعارضة؟
- هل التقسيم يحافظ على سياق الفقرات والإجراءات؟
- هل الاسترجاع يجد المقطع الصحيح بصياغات مختلفة للسؤال؟
- هل تستخدم Metadata أو مرشحات عندما توجد أقسام أو دول أو منتجات مختلفة؟
- هل تظهر الإجابة مصدرها أو تسمح بفتحه؟
- هل يرفض النظام الإجابة عندما لا يجد دليلًا كافيًا؟
- هل الصلاحيات تمنع استرجاع محتوى غير مصرح به؟
- هل لديك عملية واضحة لتحديث وحذف الملفات؟
- هل اختبرت أسئلة حقيقية وأخطاء متعمدة قبل الإطلاق؟
أسئلة شائعة عن RAG وقواعد المعرفة
هل RAG هو نفسه تدريب النموذج على ملفات الشركة؟
لا. في RAG يتم استرجاع معلومات من ملفات أو فهارس خارجية وقت السؤال ثم تمريرها للنموذج كجزء من السياق. التدريب أو Fine-tuning عملية مختلفة ولها استخدامات أخرى.
هل يمكن لـRAG منع الهلوسة نهائيًا؟
لا. يمكن أن يقلل الاعتماد على المعرفة العامة ويجعل الإجابات أكثر قابلية للتحقق، لكن قد يفشل الاسترجاع أو يفسر النموذج المصدر بصورة خاطئة. لذلك تبقى الحاجة إلى الاختبار والمصادر والرفض عند عدم كفاية الدليل.
هل أحتاج Vector Database دائمًا؟
ليس بالضرورة لكل حالة. بعض الأنظمة تستخدم خدمات بحث مُدارة أو أساليب هجينة تجمع البحث الدلالي والكلمات المفتاحية. المهم هو استرجاع المعلومات المناسبة بسرعة ودقة.
هل يمكن استخدام PDF وWord في قاعدة المعرفة؟
نعم في كثير من الأدوات، لكن جودة الاستخراج مهمة. الملفات الممسوحة ضوئيًا والجداول المعقدة والمحتوى المصور قد تحتاج معالجة إضافية قبل أن تصبح قابلة للبحث بصورة جيدة.
كم ملفًا أحتاج للبدء؟
يمكنك البدء بعشرات الملفات فقط إذا كانت تغطي حالة استخدام واضحة. الهدف من المرحلة الأولى اختبار جودة الاسترجاع والإجابة، لا جمع أكبر عدد ممكن من المستندات.